Claude Fable 5.2, Model Coding Terbaru Anthropic dan Benchmark-nya
 Peka AI · · 4 menit baca · 0 views
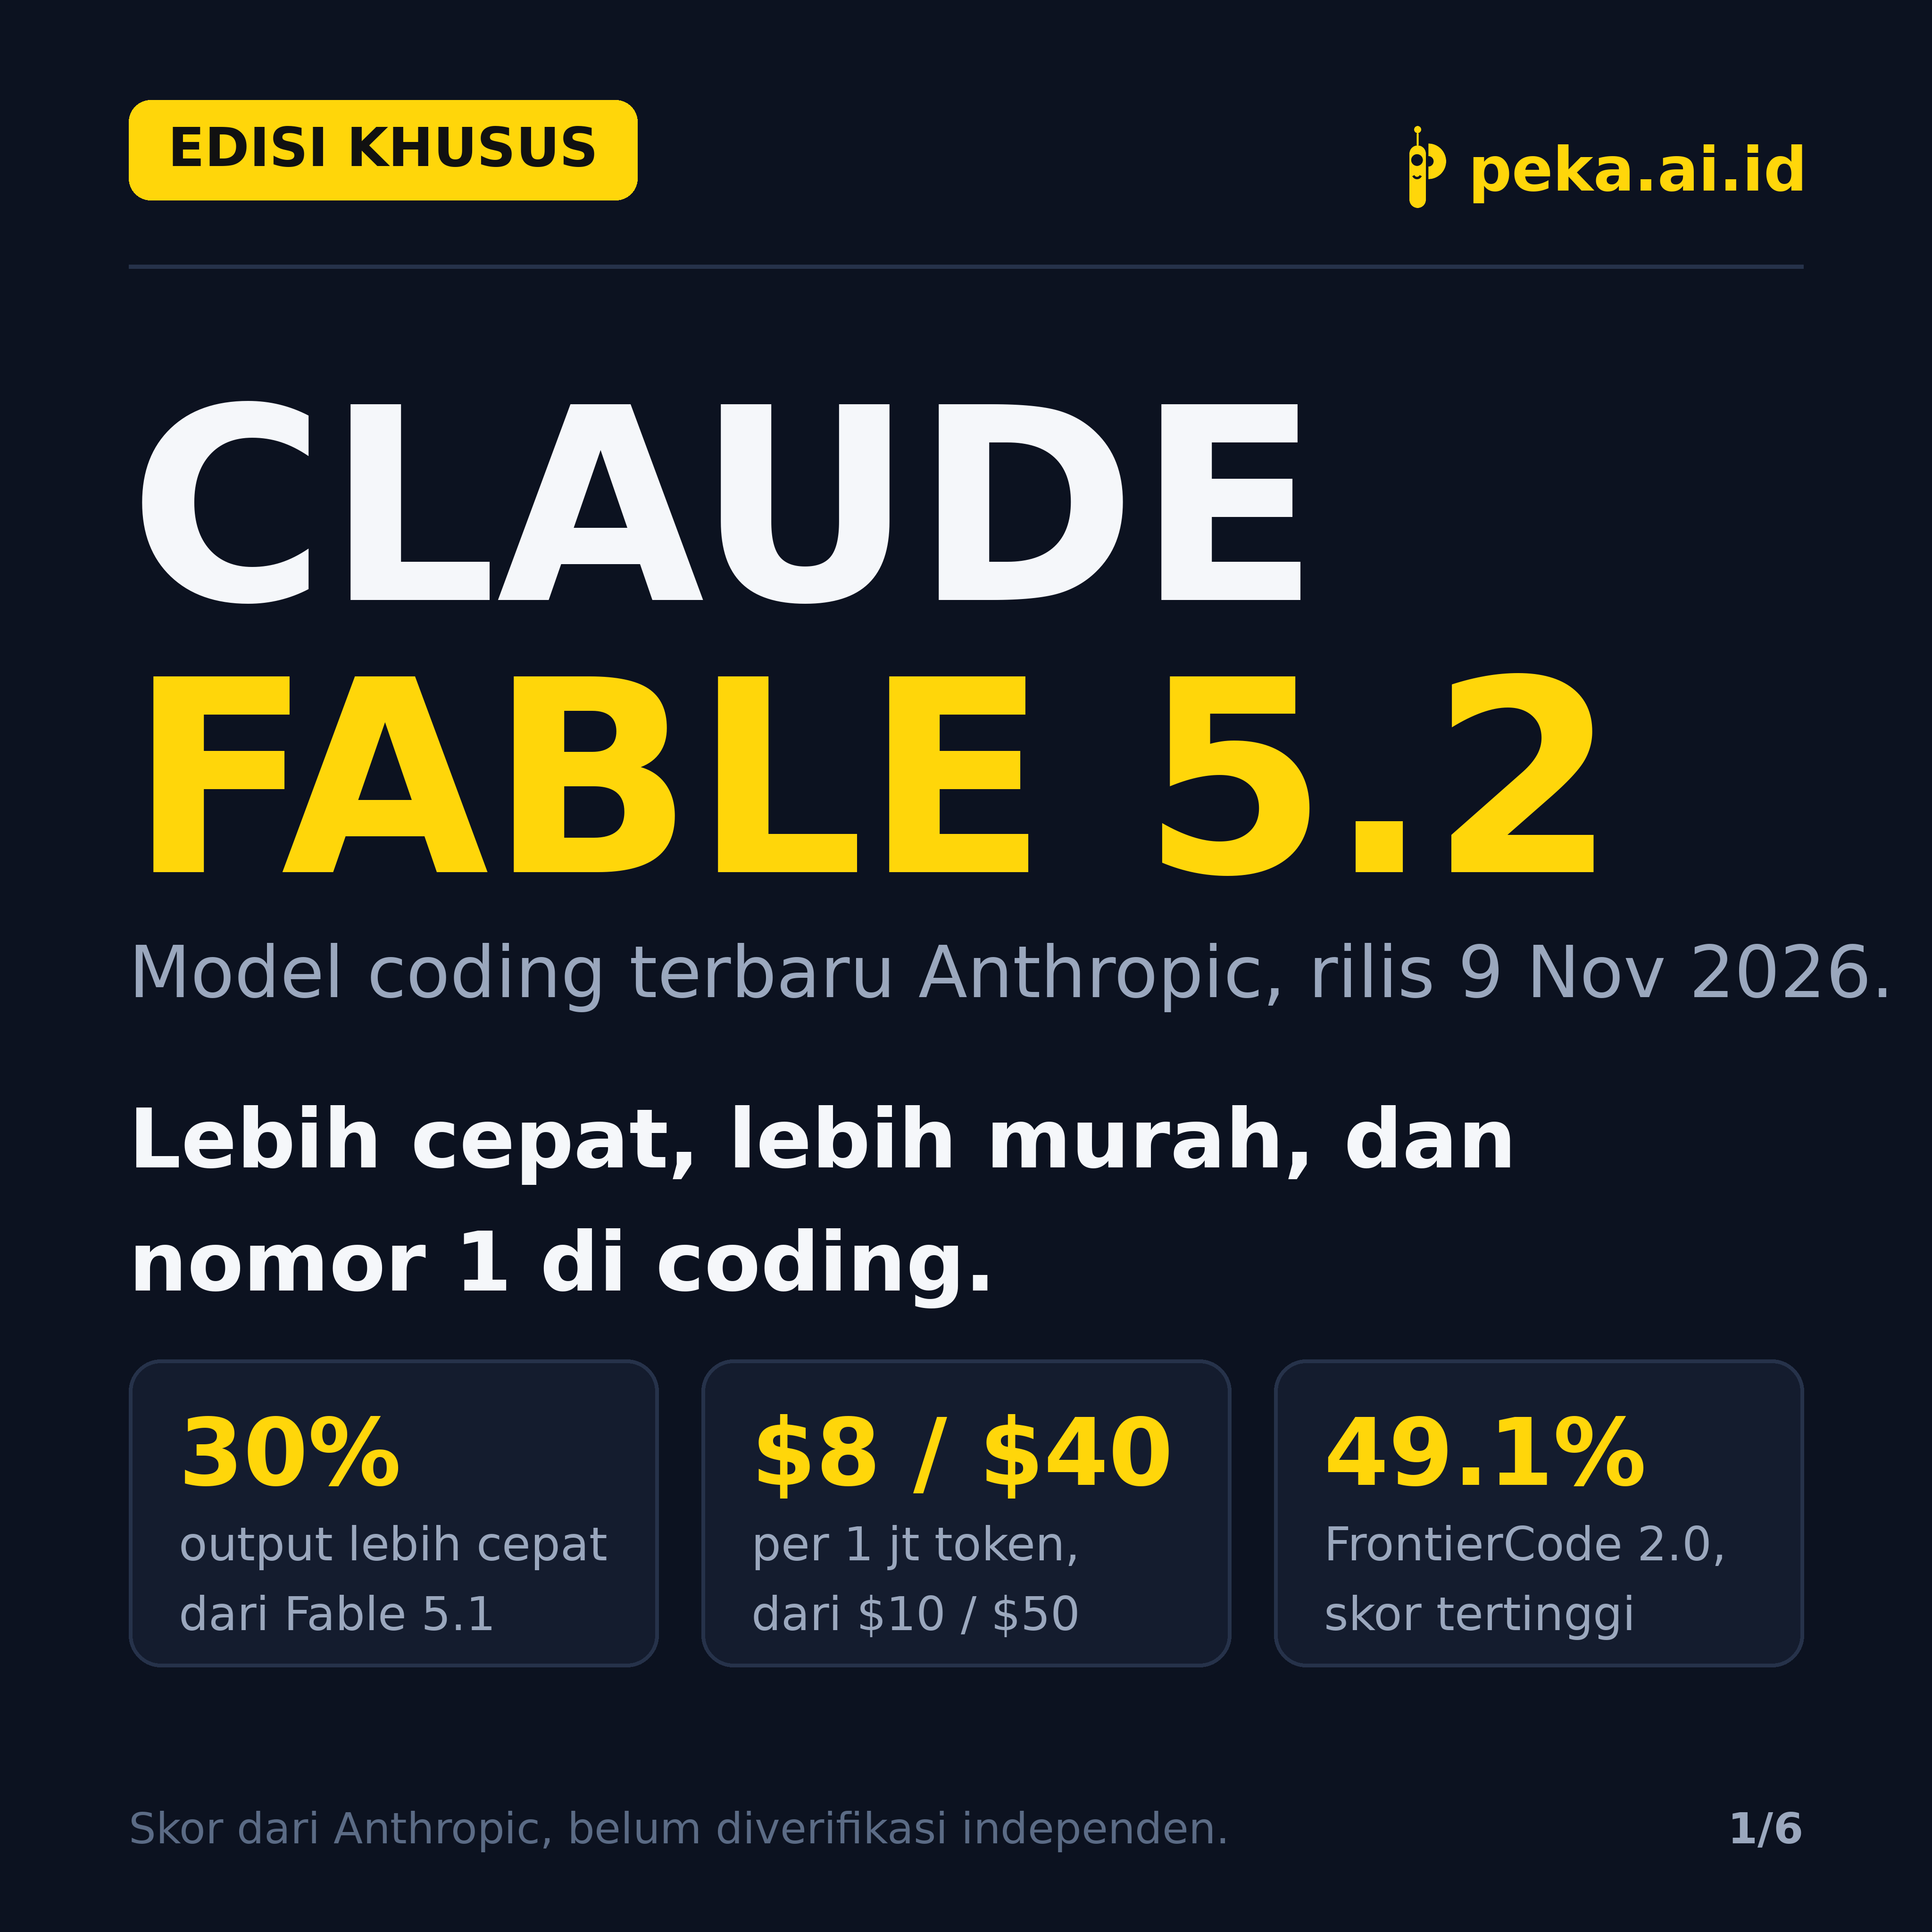
Anthropic merilis Claude Fable 5.2 dan Claude Mythos 5.2 pada 9 Nov 2026. Keduanya memakai model dasar yang sama, bedanya di pengaman. Fable adalah versi yang pengamannya aktif dan tersedia buat semua orang, sementara Mythos punya pengaman yang lebih longgar dan hanya buat organisasi yang sudah terverifikasi lewat program verifikasi cyber dan life sciences Anthropic.
Buat kita yang tiap hari pakai AI buat coding, ini rilis yang patut diperhatikan. Fable 5.2 diklaim Anthropic sebagai model coding mereka yang paling kuat sejauh ini, lebih cepat, lebih murah, dan nomor satu di beberapa benchmark coding.
Apa yang baru di Fable 5.2
Output Fable 5.2 sampai 30% lebih cepat dari Fable 5.1. Harganya juga turun 20%, dari $10 masuk dan $50 keluar per 1 jt token, jadi $8 masuk dan $40 keluar per 1 jt token. Ada mode cepat opsional yang sampai 2.5x lebih cepat, dengan harga $16 masuk dan $80 keluar per 1 jt token.
Soal pengaman, Fable 5.2 memblokir sekitar 55% lebih sedikit dari Fable 5.1, dengan penurunan 60% di kategori cyber dan 40% di kategori biologi. Fable tetap memblokir peretasan berisiko tinggi dan sebagian besar riset biologi, lalu beralih ke Opus 4.8 buat cyber dan Opus 5 buat biologi kalau memang perlu.
Fable 5.2 tersedia di Claude Platform dengan model id claude-fable-5-2, di Claude Code, dan di cloud AWS, Google Cloud, dan Azure. Di minggu peluncuran, ada promo reset limit 1 sampai 3 kali, dan Fable masuk sampai 50% dari limit mingguan buat pengguna Pro dan Team standar.
Benchmark coding: Fable 5.2 paling depan
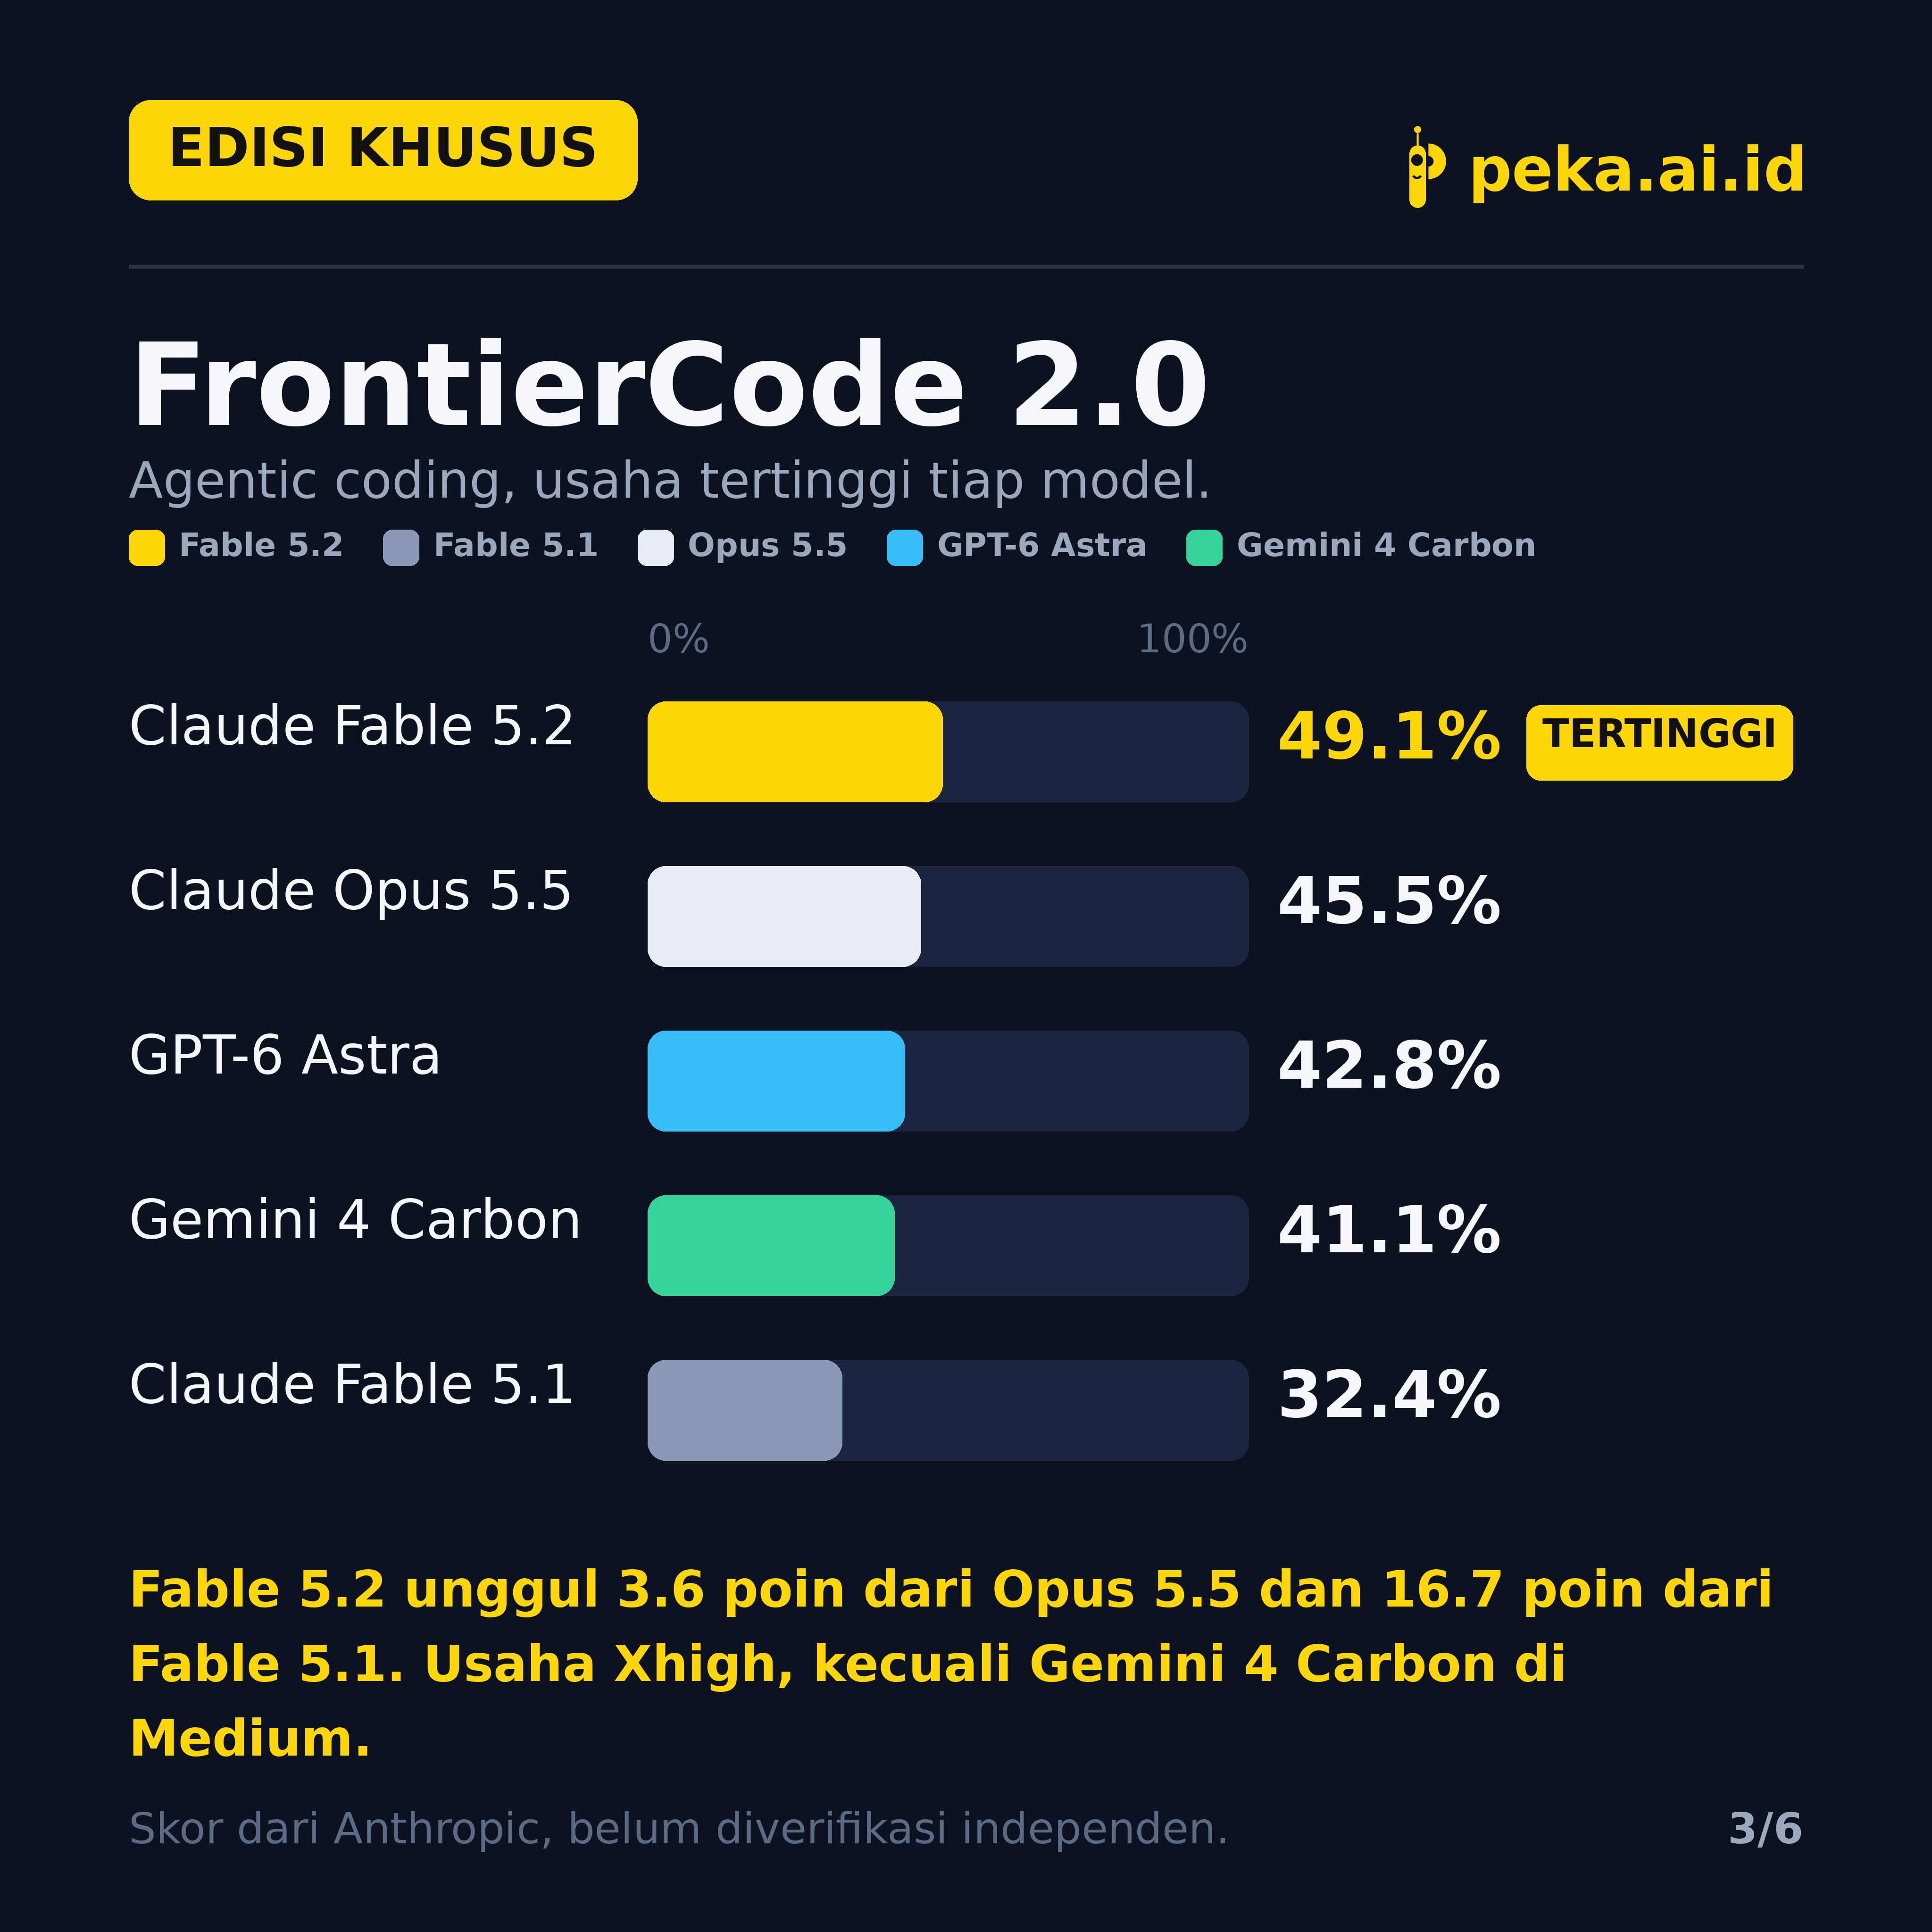
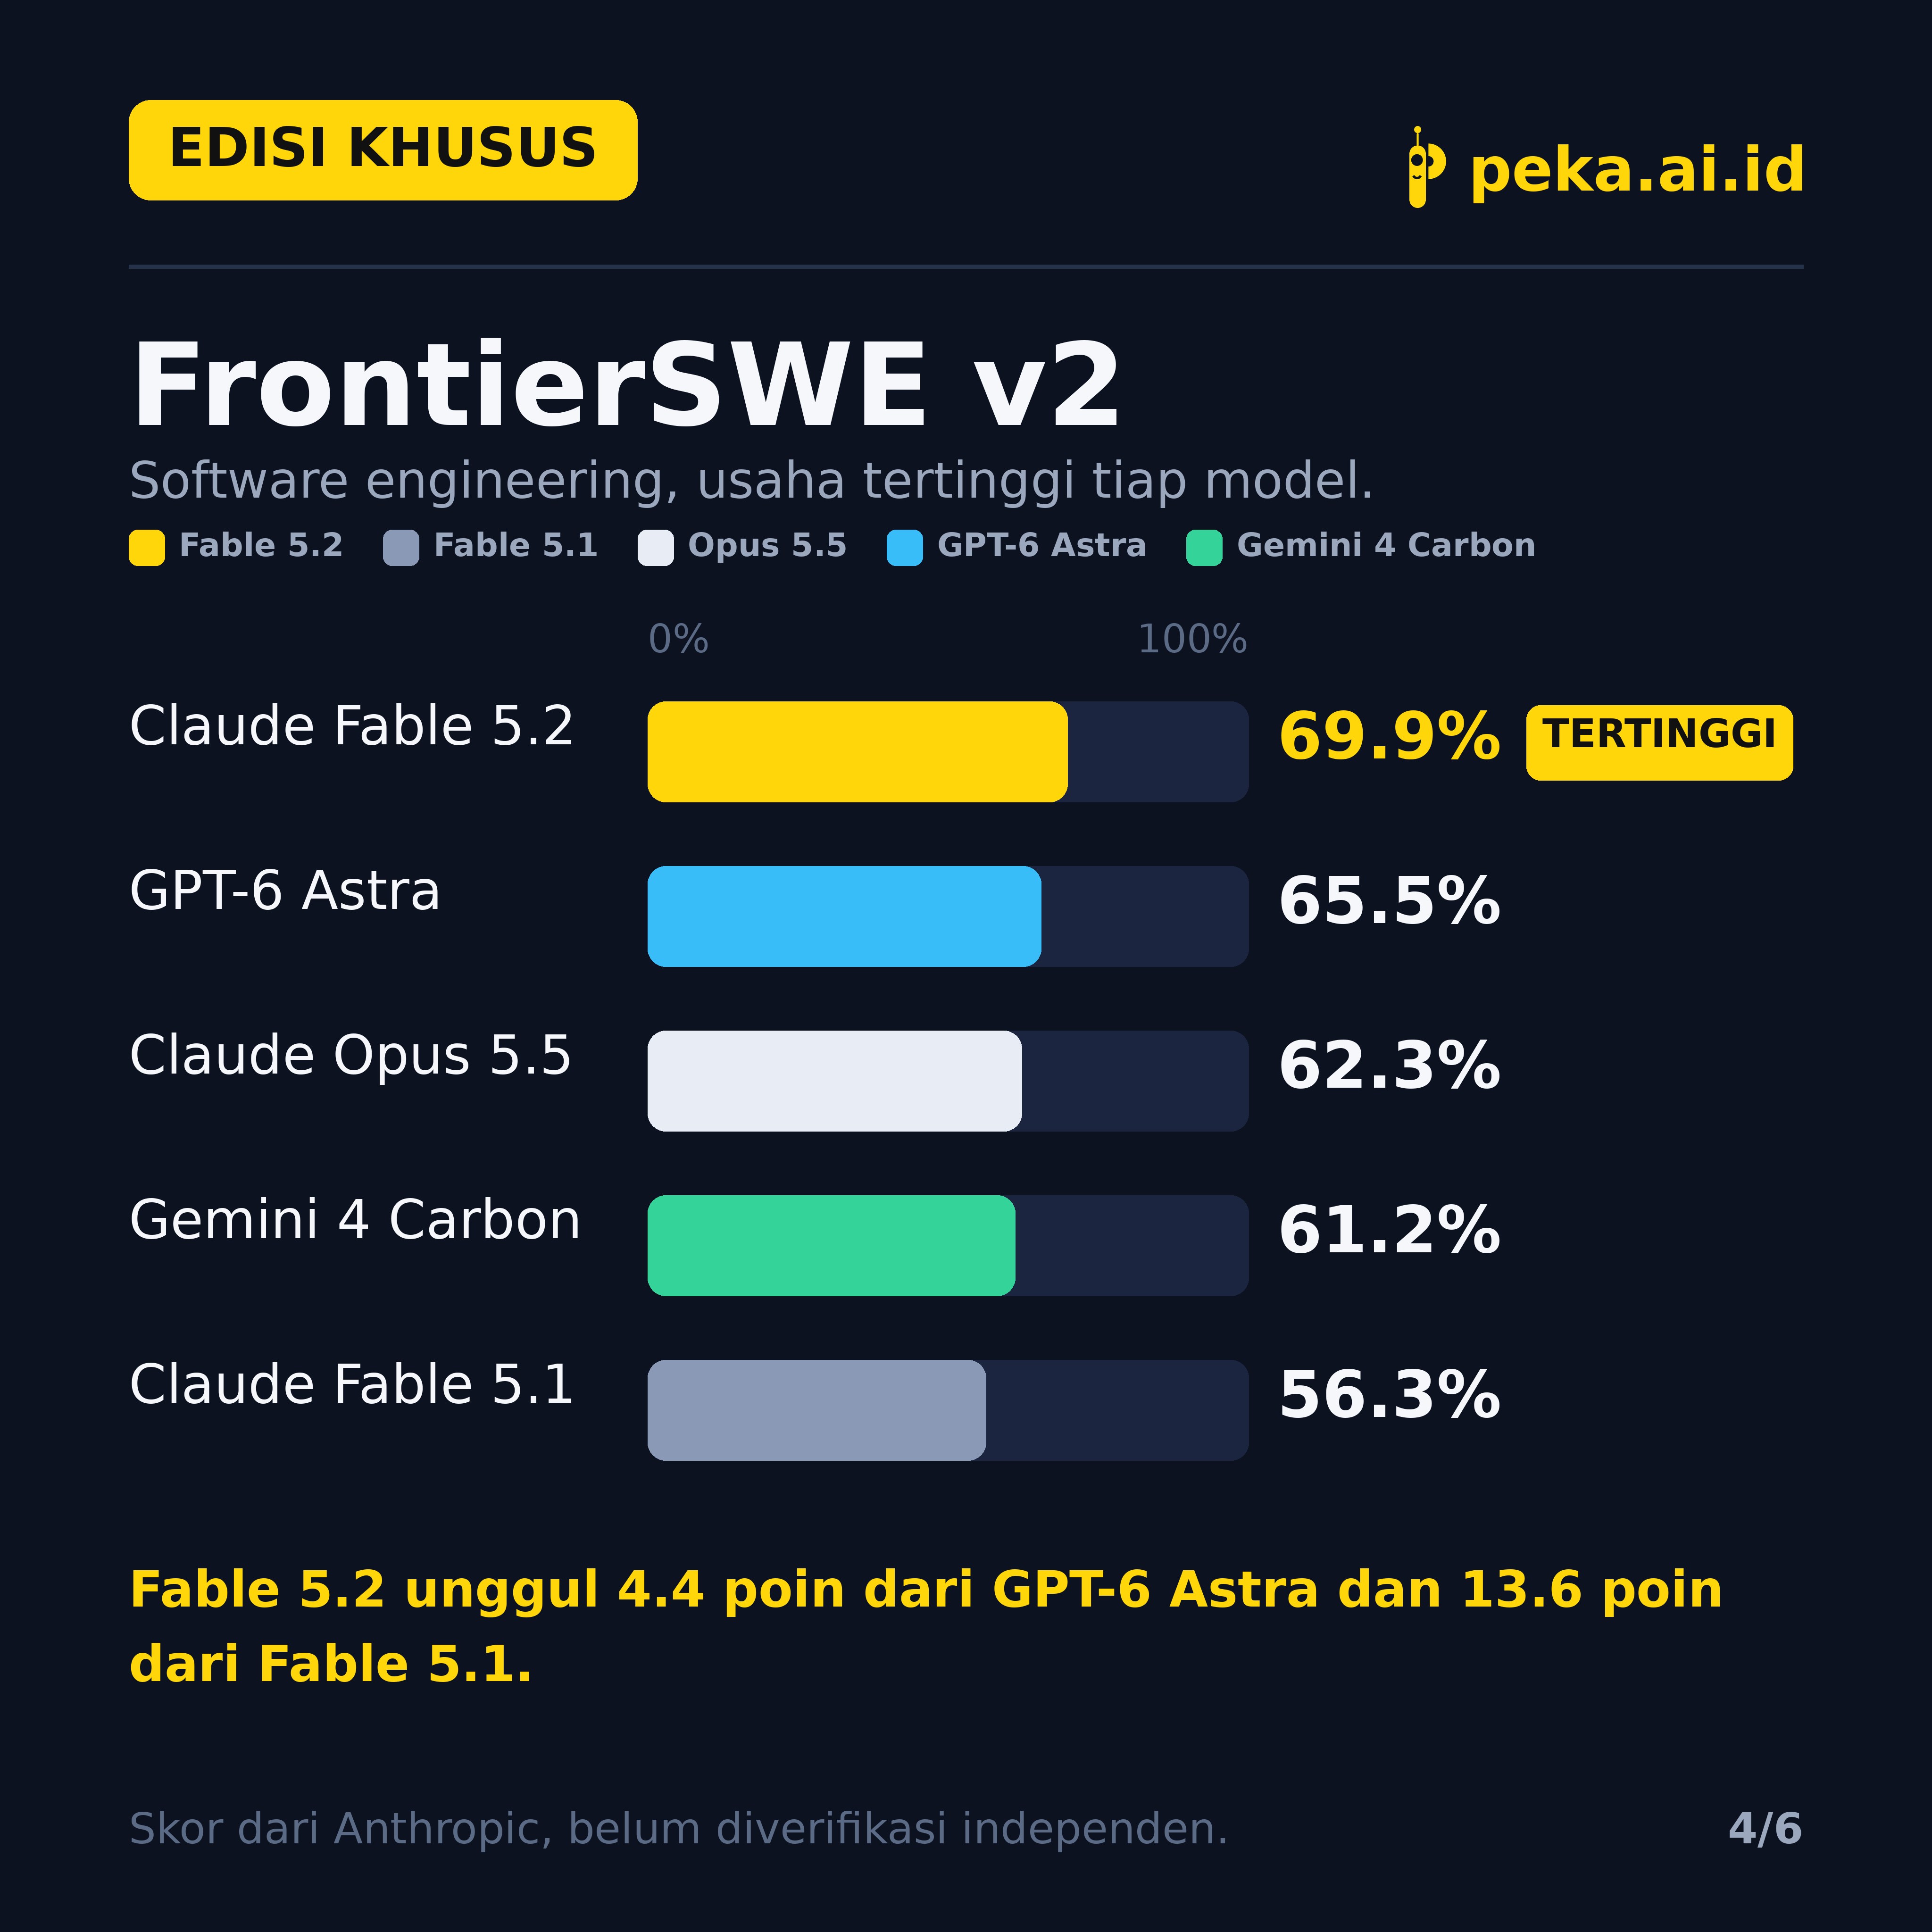
Di FrontierCode 2.0, benchmark agentic coding, Fable 5.2 mencetak 49.1%, di atas Opus 5.5 yang 45.5%, GPT-6 Astra 42.8%, Gemini 4 Carbon 41.1%, dan Fable 5.1 yang 32.4%. Di FrontierSWE v2, dia juga pertama dengan 69.9%, di atas GPT-6 Astra 65.5%, Opus 5.5 62.3%, Gemini 4 Carbon 61.2%, dan Fable 5.1 56.3%. Tiap model diuji di usaha tertinggi yang tersedia, Fable di Xhigh dan Gemini 4 Carbon di Medium pada FrontierCode 2.0.
| Benchmark | Fable 5.2 | Fable 5.1 | Opus 5.5 | GPT-6 Astra | Gemini 4 Carbon |
|---|---|---|---|---|---|
| FrontierCode 2.0 | 49.1% | 32.4% | 45.5% | 42.8% | 41.1% |
| FrontierSWE v2 | 69.9% | 56.3% | 62.3% | 65.5% | 61.2% |
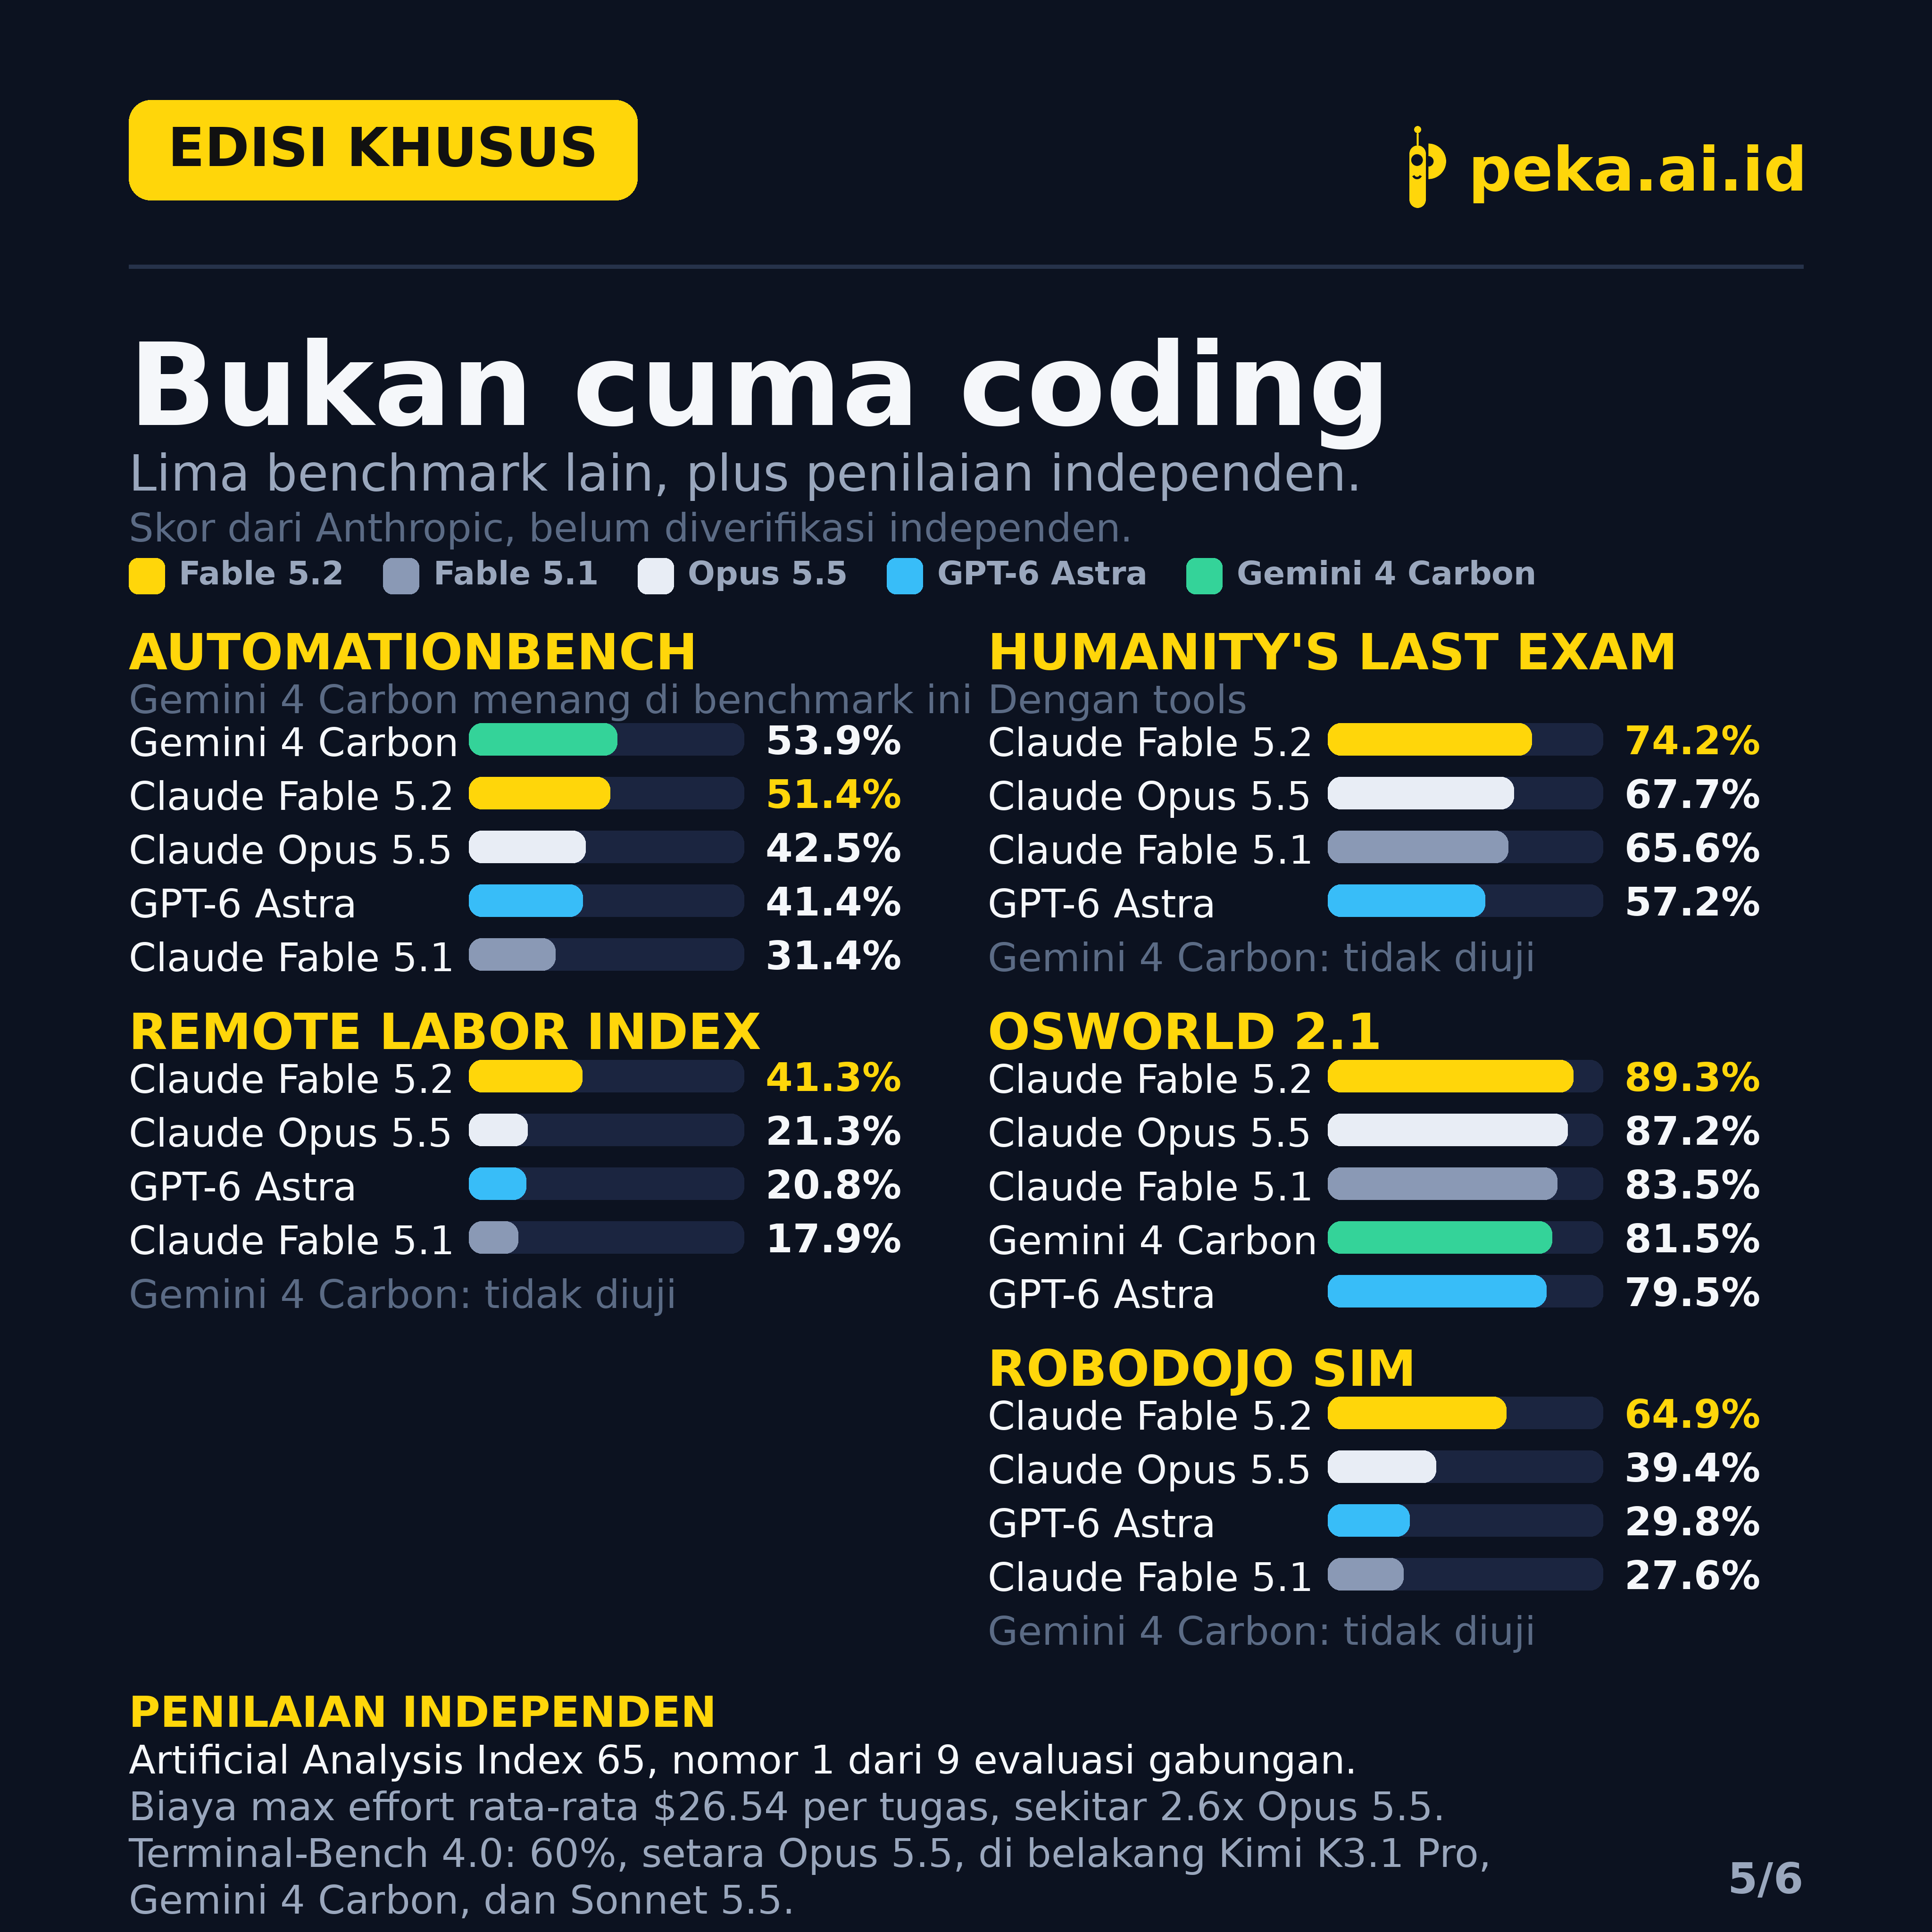
| AutomationBench | 51.4% | 31.4% | 42.5% | 41.4% | 53.9% |
| Terminal-Bench-Science 0.1 | 74.6% | 52.6% | 58.7% | 68.1% | 64.8% |
| OSWorld 2.1 | 89.3% | 83.5% | 87.2% | 79.5% | 81.5% |
| RoboDojo Sim | 64.9% | 27.6% | 39.4% | 29.8% | tidak diuji |
| Remote Labor Index | 41.3% | 17.9% | 21.3% | 20.8% | tidak diuji |
| Humanity's Last Exam (dengan tools) | 74.2% | 65.6% | 67.7% | 57.2% | tidak diuji |
| Chartography | 73.4% | 44.8% | 64.4% | 71.0% | 72.5% |
Jujur saja, tidak semua dia menangkan
Di AutomationBench, benchmark alur kerja bisnis, Gemini 4 Carbon yang menang dengan 53.9%, di atas Fable 5.2 yang 51.4%. Di rubrik AA-Briefcase v1.1, Fable 5.2 memang pertama dengan 66.1%, tapi di skor Elo justru Opus 5.5 yang menang dengan 1800, di atas Fable 5.2 yang 1785.
Penilaian independen juga memberi gambaran yang lebih seimbang. Di Artificial Analysis Intelligence Index, gabungan 9 evaluasi, Fable 5.2 di usaha maksimal memang nomor 1 dengan skor 65, di atas Gemini 4 Carbon 60, Opus 5.5 59, dan GPT-6 Astra 57. Tapi di usaha maksimal itu, Fable 5.2 menghabiskan biaya rata-rata $26.54 per tugas, sekitar 2.6x Opus 5.5. Dan di Terminal-Bench 4.0, Fable 5.2 mencetak 60%, setara Opus 5.5 dan di belakang Kimi K3.1 Pro, Gemini 4 Carbon, dan Sonnet 5.5.
Bukti kerja nyata di balik angka
Anthropic memamerkan beberapa demo. Claude membangun sistem operasi yang bisa jalan dalam 8 hari, memakai lebih dari 1,000 subagent, lengkap dengan kernel sendiri, driver, penyimpanan file, jendela, layar login, dan installer, dan sistem itu bisa boot di laptop. Bersama Diode, Claude merancang 3 perangkat elektronik yang bisa jalan, hub asisten suara rumahan, speakerphone USB, dan hewan peliharaan virtual genggam, dengan papan siap kurang dari sehari.
Claude juga memecahkan 2 soal fisika black hole yang masih terbuka, dan memformalkan Teorema Terakhir Fermat dalam 30 jam, padahal percobaan pertama butuh 11 hari, sementara Opus 5.5 dengan persiapan yang sama hanya sampai 26% dalam 18 jam. Anthropic bilang lebih dari 90% perubahan yang masuk ke codebase inti mereka kini ditulis Claude dengan panduan manusia.
Jadi kapan pakai Fable 5.2
Panduan Anthropic sendiri jelas. Fable dan Mythos buat kerja teknis paling ambisius dan terbuka, sementara Opus 5.5 tetap jadi andalan harian. Buat kita, artinya begini. Kalau kamu mengerjakan proyek coding besar yang butuh agent jalan lama dan mandiri, Fable 5.2 layak dicoba, apalagi di minggu peluncuran ini ada promo limit. Kalau kerja harianmu biasa saja, Opus 5.5 sudah cukup, dan tagihanmu juga lebih ramah.
Satu hal yang wajib diingat, semua skor di atas adalah klaim dari Anthropic, belum diverifikasi independen, kecuali penilaian Artificial Analysis yang memang independen. Jadi baca angka ini sebagai klaim vendor, bukan vonis akhir.
kasih rating tulisan ini
belum ada penilaian